 乐维官网
案例解读 | 全球领先化工工程建设央企运维管理平台实践
511乐维为化工央企打造统一运维管理平台:操作系统、数据库、网络、云平台全栈监控,辅以3D机房、业务拓扑、自动化脚本库及ITSM联动。信创环境全面适配,运维合...
View details热门搜索 企业动态 新闻中心 成功案例 社区 Prometheus交流区
业务洞察以业务为核心,打通IT资源与业务系统的关联,让运维监控不再局限于设备层面,而是转向以业务视角驱动的运维管理。借助先进的运维平台,可以将分散的运维系统数据整合为业务全景视图,实现从“看设备”到“看业务”的质变,最终提升运维效率与业务连续性。
适用于业务系统数量多、单个业务依赖多个IT资源的客户环境。资源异常时,仅看设备指标难以判断业务影响,需要建立面向业务的统一监控视角。
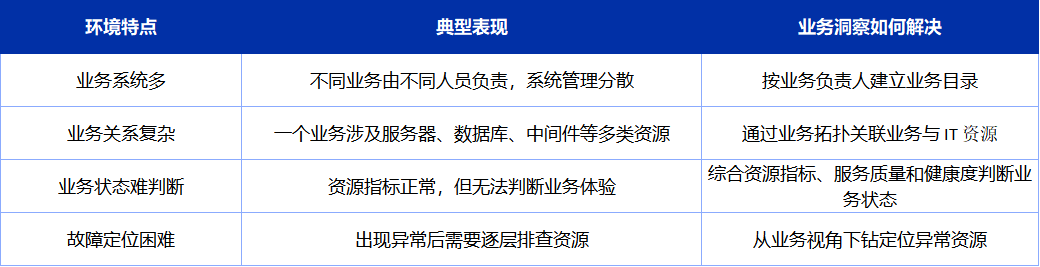
痛点:只有设备监控,看得见指标,却看不懂业务。告警来了,值班人员看到的是IP、主机名和一条技术描述;但最需要立刻回答的是:影响哪个业务、该找谁、下一步看哪里。
设备监控解决“有没有告警”;业务洞察解决“影响什么业务、由谁负责、从哪里继续查”。
采用“业务负责人 → 业务系统 → IT 资源”的组织模型,先让业务有责任人,再让资源有业务归属,最后校准资源关系和采集体量。
按实际业务管理职责建立目录:业务负责人作为一级目录,其负责的业务系统归入目录下。业务异常时,目录本身就能给出责任边界。
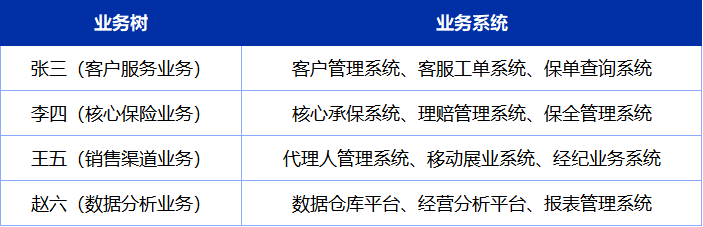
配置要点:目录树先求准确、再求完整:先覆盖核心业务和明确的责任人,再逐步补充其他业务业务
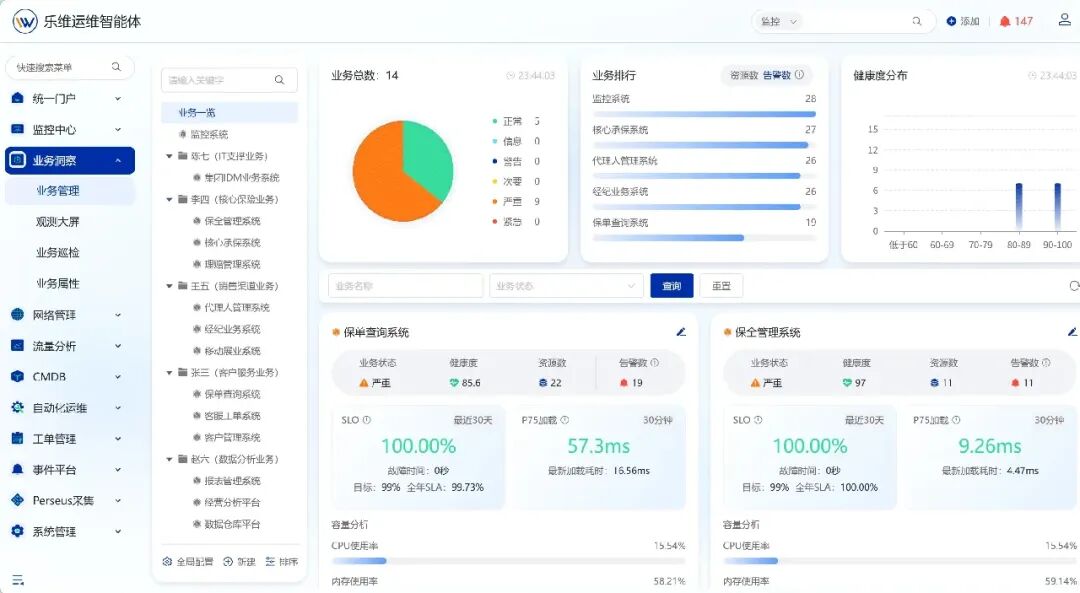
目录树示例
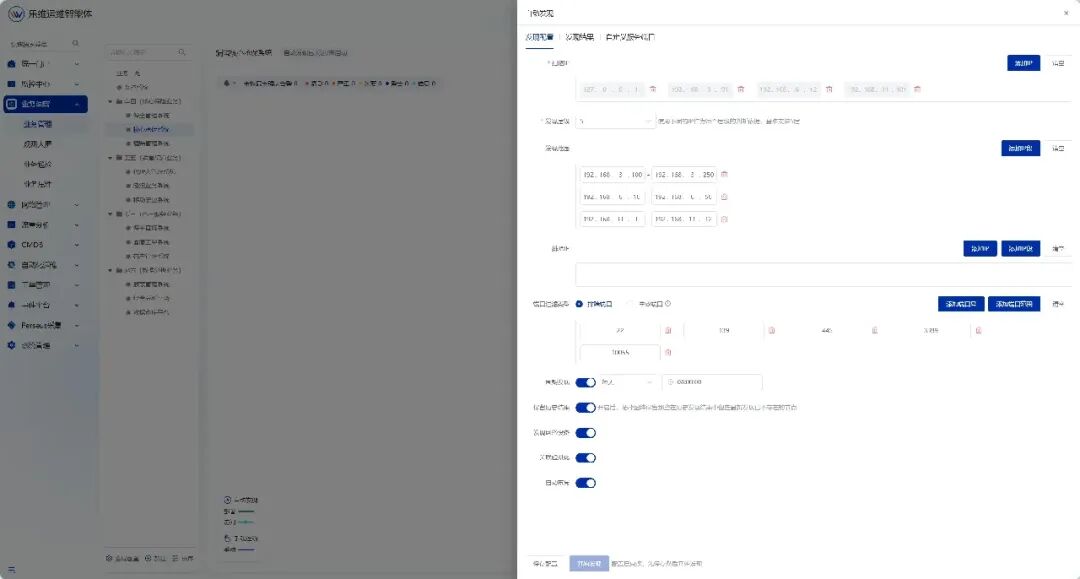
业务拓扑配置示例
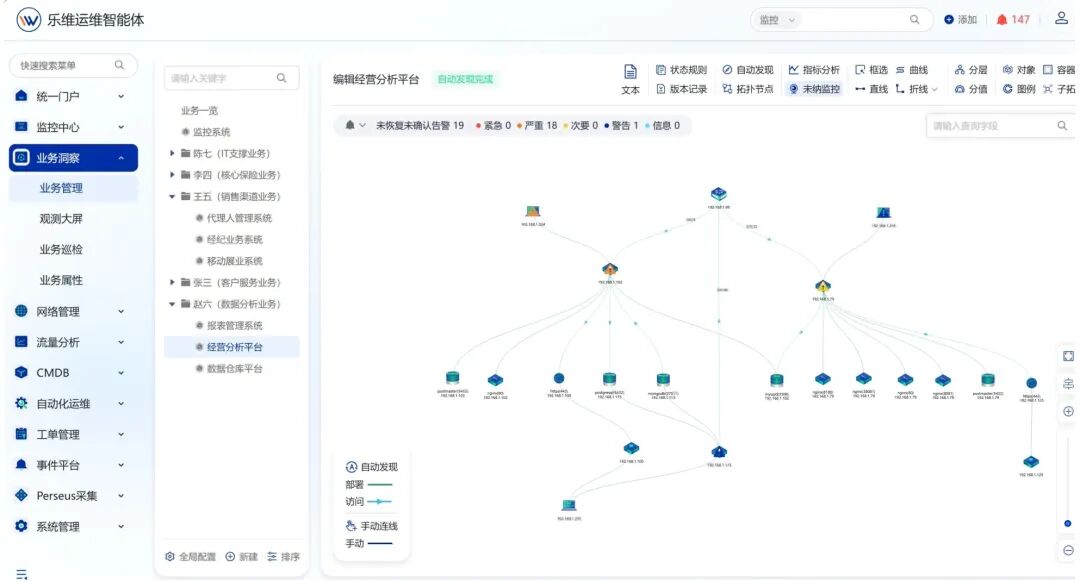
业务拓扑图展示
目录树规划后,先找业务负责人调研,而不是直接开自动发现。调研结果决定发现范围、资源归属和校准基准。
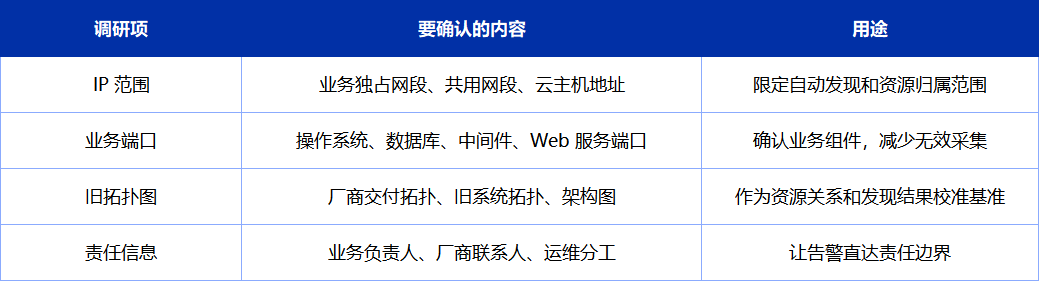
用调研出的IP范围和端口配置自动发现后,建议按下面顺序整理结果:
落地顺序:先明确业务负责人,再建立业务目录;先调研资源范围,再配置自动发现;先校准关键业务资源,再扩展采集体量。
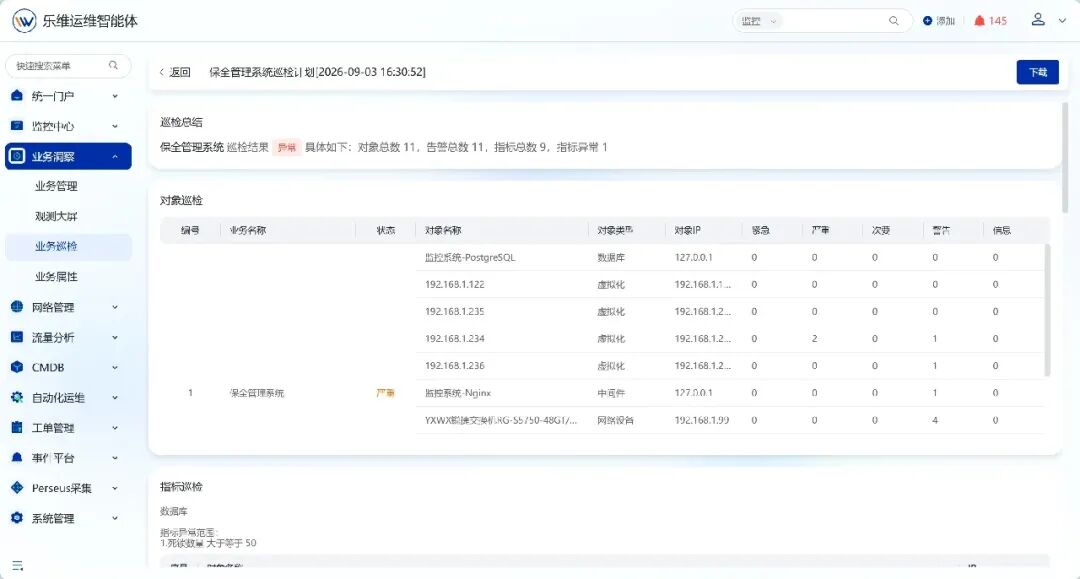
问题:逐台检查主机、数据库、中间件,耗时长且容易漏重点。
解决:对核心业务配置每日巡检,覆盖CPU、内存、文件系统和数据库死锁等数据
效果:先看业务健康和异常清单,再决定是否下钻资源,巡检标准固定、结果可追溯。
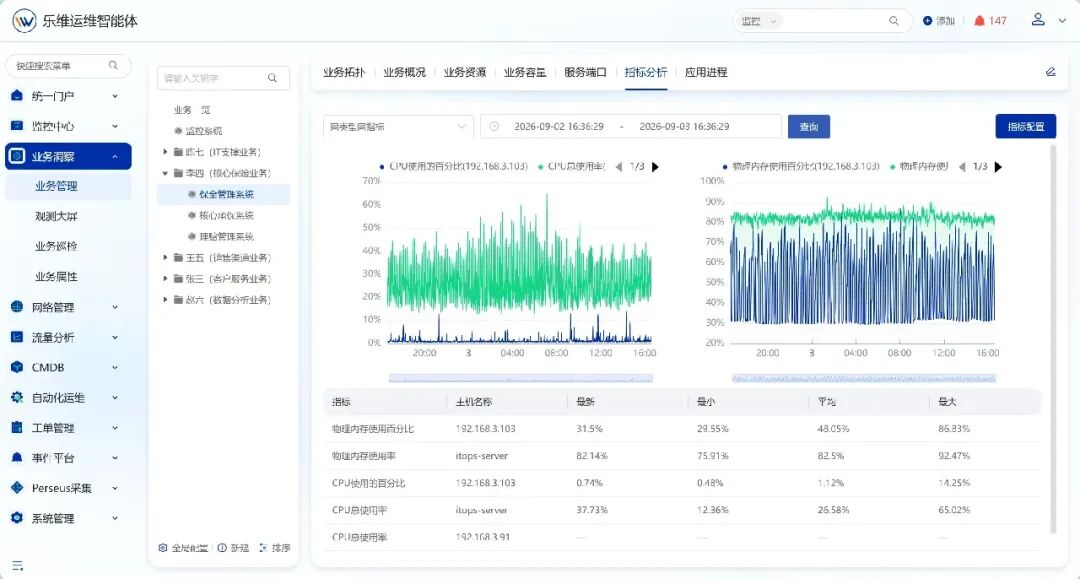
问题:核心业务存在明显高峰和低谷,异常波动难以被及时发现。
解决:选择CPU、内存、文件系统使用率等关键指标,按指标类型聚合,展示最近24小时趋势,并结合历史数据观察变化。
效果:直观看到每日高峰时段和异常波动,为资源调整和风险预判提供依据。
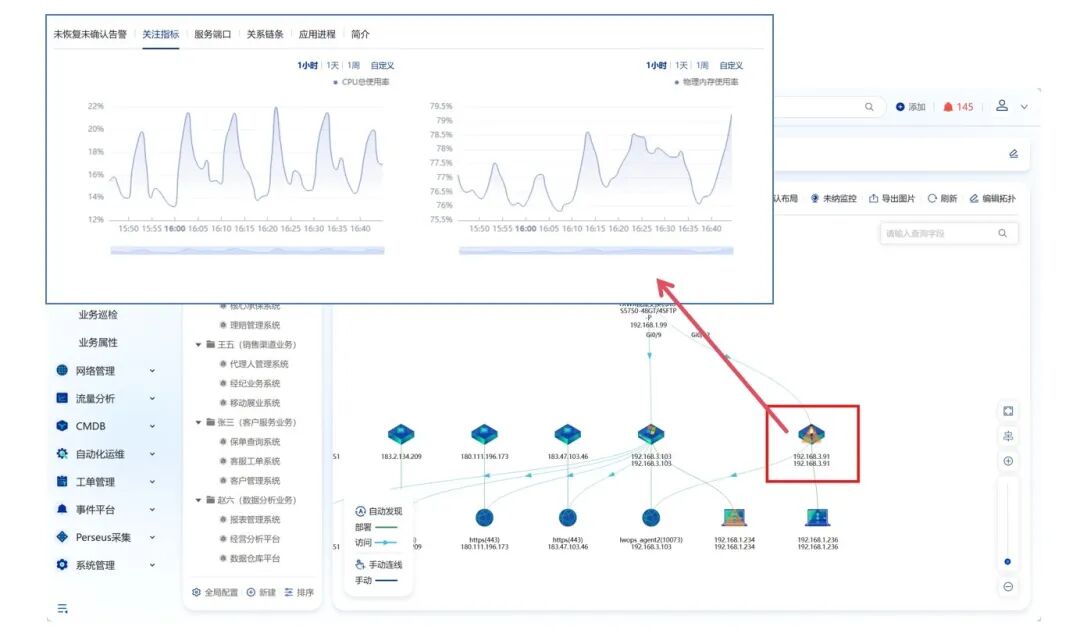
问题:业务异常后,需要判断来源是业务本身、主机、数据库还是中间件。
解决:进入异常业务的业务拓扑,查看关联资源及对应指标,再逐层下钻定位异常。
效果:从业务视角快速缩小故障范围,减少逐台设备排查。
免费版已开放下载,点击立即体验乐维运维智能体 。

乐维为化工央企打造统一运维管理平台:操作系统、数据库、网络、云平台全栈监控,辅以3D机房、业务拓扑、自动化脚本库及ITSM联动。信创环境全面适配,运维合...
View details
Zabbix和Prometheus都是非常流行的监控系统。它们有许多相似之处,但也有一些不同之处。以下是Zabbix和Prometheus监控对比的一些关键点:
View details
Zabbix与乐维监控对比分析专题系列文章的第六篇——图形图表篇,包括二者在模板图形及模板表格等功能的对比分析。
View details
zabbix_sender是Zabbix监控系统中用于向Zabbix服务器发送数据的命令行工具。以下是zabbix_sender基础命令教学
View details
HelloPlease log in