 乐维官网
监控新势力VS传统实力派:乐维智能监控为何能替代Tivoli?
13708将开源从30分提高到100分的乐维智能监控替代了Tivoli
View details热门搜索 企业动态 新闻中心 成功案例 社区 Prometheus交流区
#DeepSeek崩了#冲上热搜,大量用户反馈网页对话无法提交、API接口返回服务器繁忙,不少接入DeepSeek API的企业业务直接受阻。从现象来看,本次故障波及网页端、V4 Pro、V4.1 Flash等API服务,高峰时段报错频发,部分用户直到上午才逐步恢复。
这不是大模型厂商第一次出现大规模中断,也给所有正在落地AI应用的企业敲响警钟:大模型能力越强,对底层IT基础设施的可靠性、可观测性要求越高。
很多企业在引入大模型时,焦点都放在模型能力、Token成本、对话效果上,却容易忽略一个关键点:AI应用本质是一套复杂分布式系统,GPU集群、服务器、网络、容器、API调用链路任何一环异常,都会引发业务雪崩。
传统监控只看服务器是否ping通,无法识别GPU显存溢出、推理队列堆积、API时延突增、接口5xx错误、限流429等AI场景特有故障。等到用户投诉爆发,运维才后知后觉,错过了最佳预警窗口。
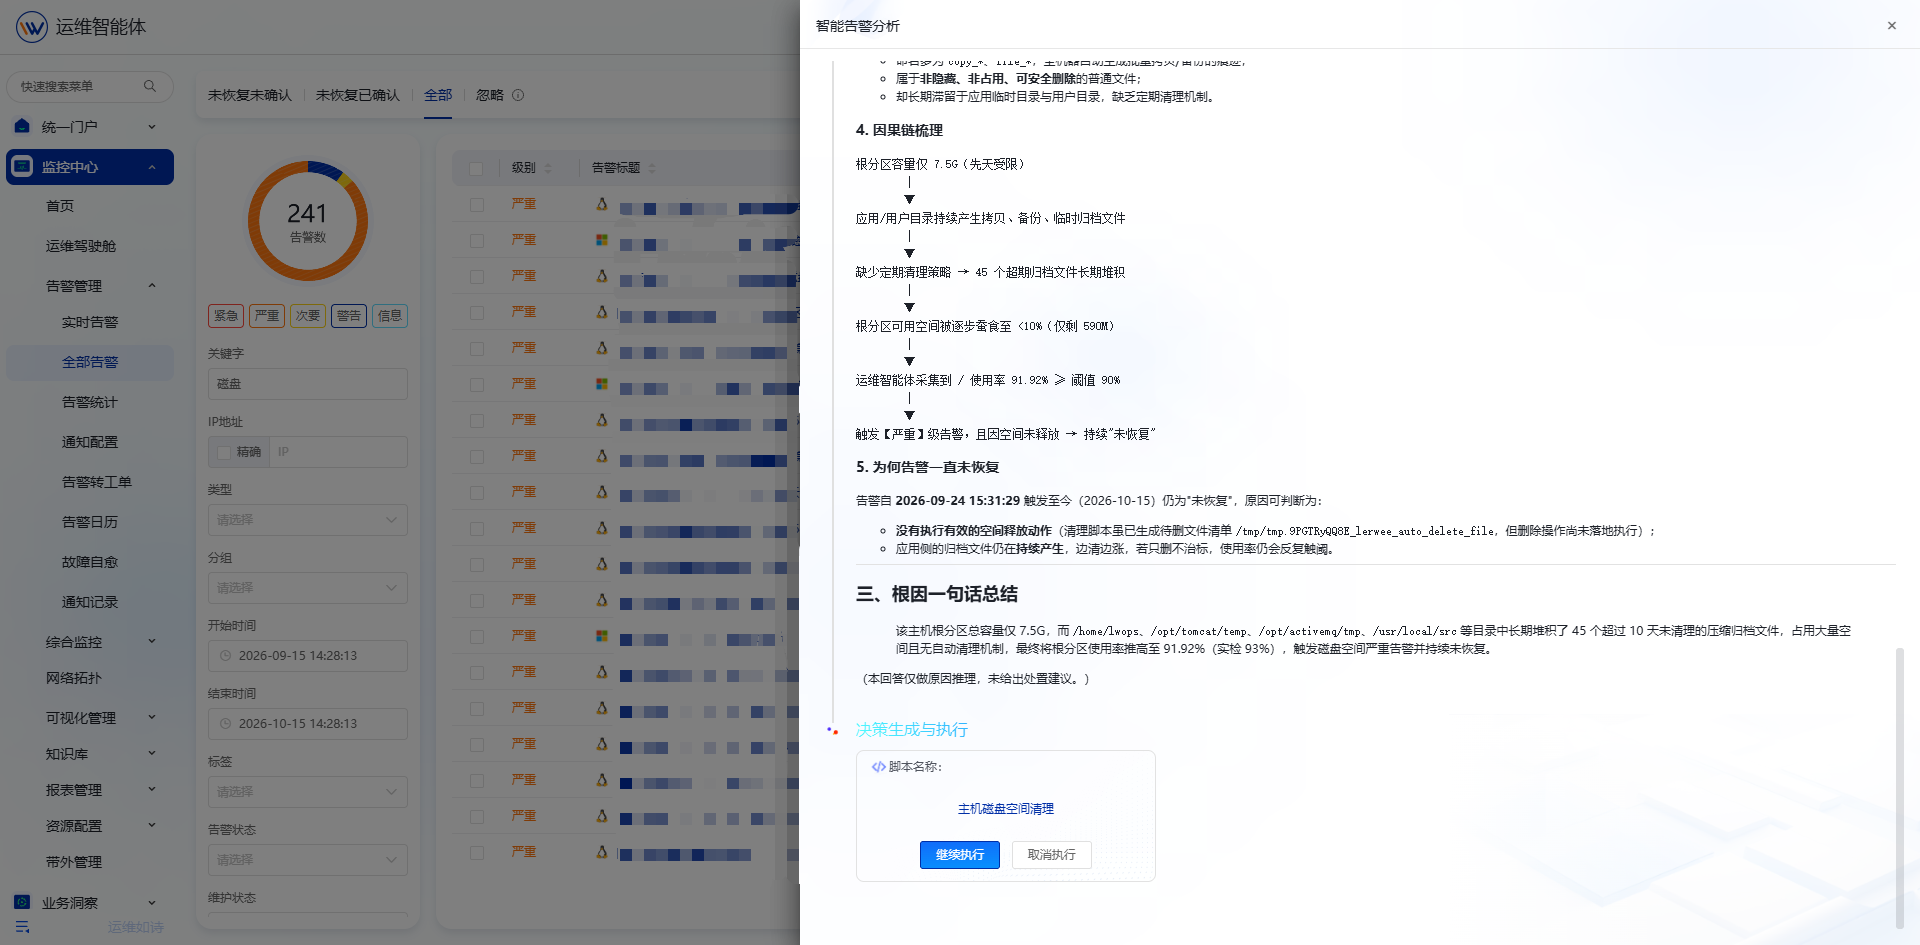
在AI时代,大模型服务依赖服务器、GPU集群、容器、中间件与API链路等异构IT基础设施。乐维一站式智能运维监控平台,统一纳管全栈资源,为AI业务构建可观测底座。
统一监控服务器、GPU集群、容器、中间件与API链路,打破监控孤岛,全局掌握大模型服务的底层运行状态。
支持自定义API拨测,灵活配置探测规则,实时监测大模型接口健康状态,接口异常及时感知。
提前发现算力瓶颈、接口超时、服务异常等风险,让运维从被动响应转向主动预警。
让AI业务故障从“用户投诉才发现”,变成“监控先预警、运维早处置”,提升故障响应效率,保障AI服务连续稳定。
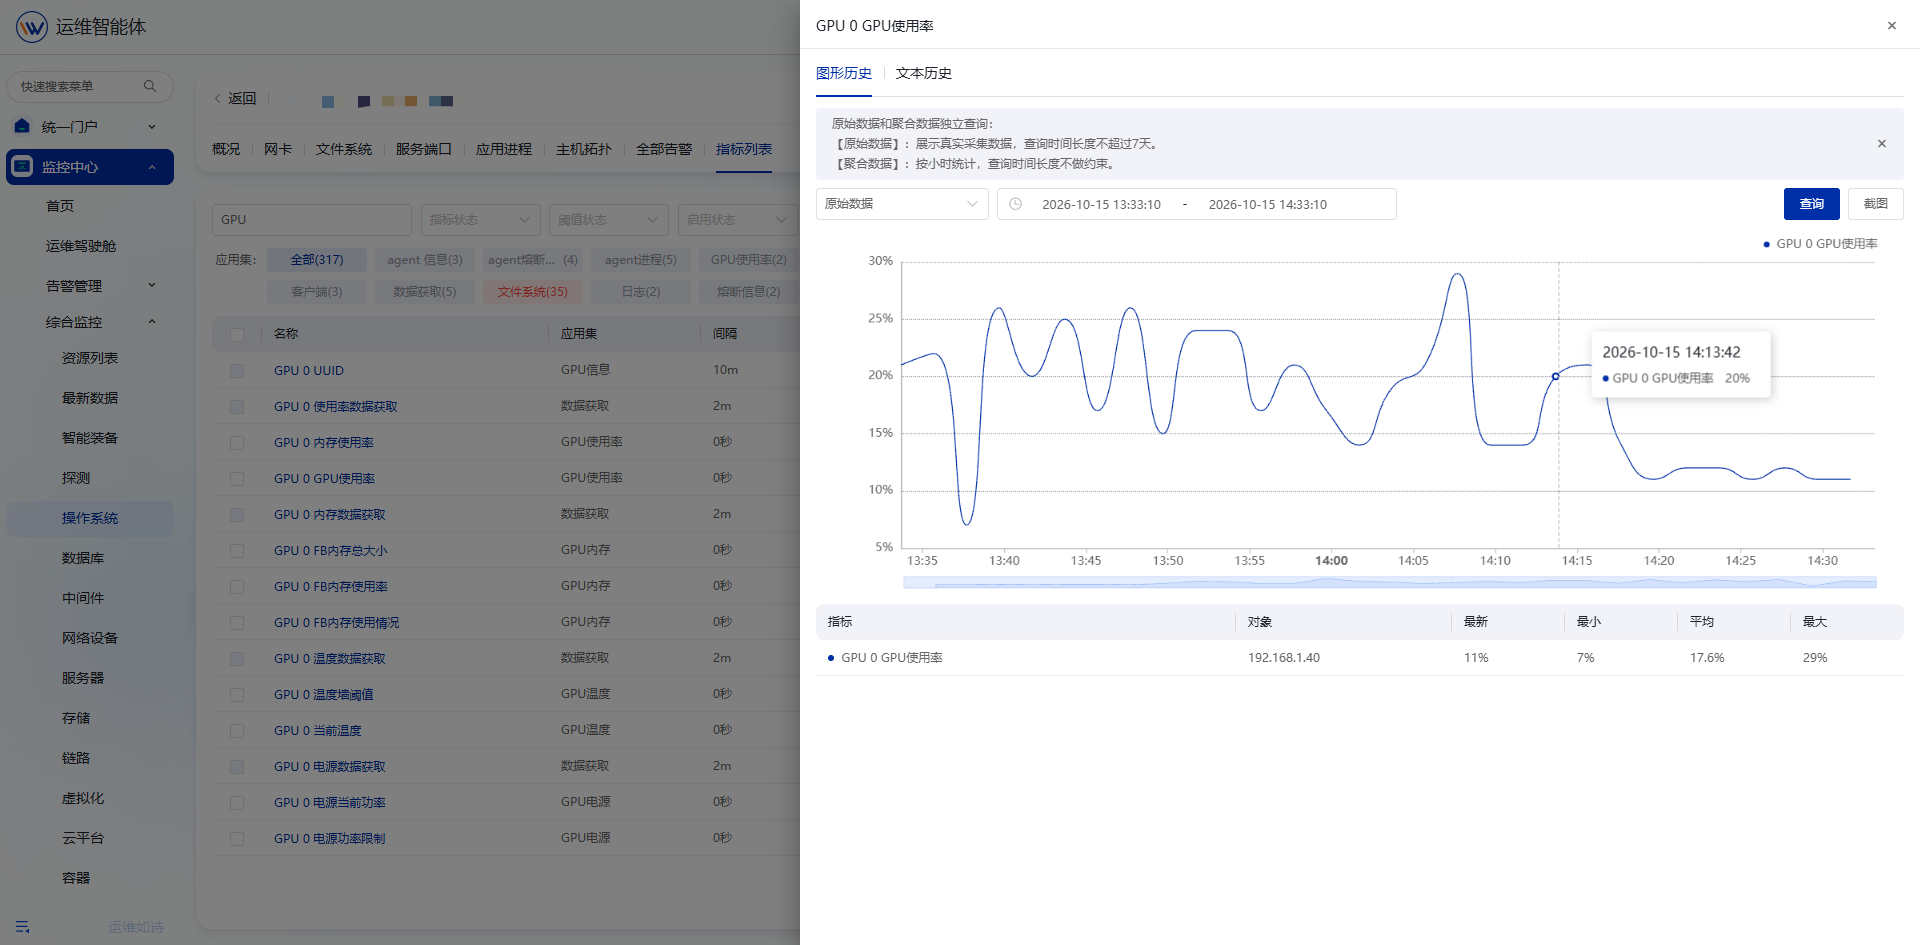
划重点:我们既要用好DeepSeek这类强大的大模型能力,也要建好运维观测体系。大模型是业务的 “大脑”,而运维监控,就是守护大脑稳定运行的 “神经系统”。当AI服务突发中断,完善的监控 + 智能根因能力,才是企业业务的兜底保障。
乐维社区已经开放乐维运维智能体免费版,欢迎下载使用!
HelloPlease log in