 乐维官网
案例解读丨华南某电子集团IT监控实践
15214乐维为该公司部署了集中监控、集中告警、可视化试图、多样性报表和大屏展示等功能。
View details热门搜索 企业动态 新闻中心 成功案例 社区 Prometheus交流区
该医疗机构为区域内非营利性三级综合公立医院,是自贸片区唯一的三级综合公立医院,也是华南地区首家取得JCI复审金牌的综合公立医院,集医疗、教学、科研、预防、康复、健康管理于一体,打造国际化医疗服务标杆,面向片区居民及境外人士提供优质医疗服务,着力建设粤港澳大湾区国际化医疗服务平台。
先看这家医院的IT环境构成:华为的服务器和存储、深信服SCP虚拟化平台、Windows与Linux两类操作系统、MySQL和SQL Server两类数据库、Nginx中间件,再加上华为交换机组成的网络层。
这个清单很典型。医院信息科的普遍处境是:业务系统多而关键,IT团队却不大。HIS(医院信息系统)、EMR(电子病历)、LIS、PACS等核心业务需要7×24小时连续运转,挂号、收费、诊间叫号任何一环卡顿,临床一线立刻能感知到;但支撑这些业务的IT资源往往来自多个品牌、多个技术栈,设备数量不少、种类繁杂。
对这样一支团队来说,最大的挑战不是”某一种设备不会管”,而是异构资源的分散管理:每类设备有各自的管理界面和查看方式,运维人员只能逐台登录巡检。这正是本案例所有痛点的共同起点。
无统一监控平台,运维被动低效。全栈资源依赖人工逐台登录巡检,缺乏自动化集中监测手段。这是根因本身:设备分散管理,人跟着设备跑。
资源状态盲区大,隐患难预判。华为交换机链路质量、存储控制器状态、Nginx服务进程、服务器资源负载等核心指标没有实时采集与留存。没有数据,隐性硬件故障和性能瓶颈就无从提前发现,突发业务中断只是时间问题。
故障事后发现,排查效率低。因为没有前置的运行数据,故障发生后运维人员缺乏状态依据,只能逐设备、逐链路盲目排查,故障定位耗时长、业务恢复周期不可控。
运维缺乏数据支撑,决策盲目。无指标采集、无日志留存、无历史数据,设备负载、资源利用率、故障频次、系统可用性都无从统计——存储要不要扩容、服务器要不要迭代,全凭感觉。
报表管理低效,数据价值难释放。纸质报表或零散的Excel记录,统计困难、格式不统一、口径不一致,跨部门协作时数据对不上,管理层也难以第一时间掌握系统运行状态。
逐条细读会发现,它们不是五个孤立的问题,而是同一根因在不同层面的症状——没有统一的监控平台,运维只能被动进行。
将院区全部服务器、存储、网络设备、虚拟化平台、操作系统、数据库及中间件统一接入一个平台,打破异构资源分散管理的现状。
这是整个项目的基础动作,也是技术含量最高的一步。华为、深信服、Windows、Linux、MySQL、SQL Server、Nginx……要在一个平台里同时管住这些异构资源,监控产品必须具备广泛的采集适配能力。
这正是乐维监控的底座设计:其Perseus采集管家支持多Server、多Proxy架构,兼容SNMP、SNMP Trap、Agent、SSH、Telnet、WMI、ODBC、JMX、IPMI、SMI-S、Redfish、HTTP、Syslog等数十种协议,并通过”基因技术自动适配”识别设备类型、厂商和型号,适配500+厂商、8000+设备型号、100000+指标体系。
对用户来说,这意味着不必为每一类设备单独采购或单独登录管理工具——一个平台接进来,全部纳管。
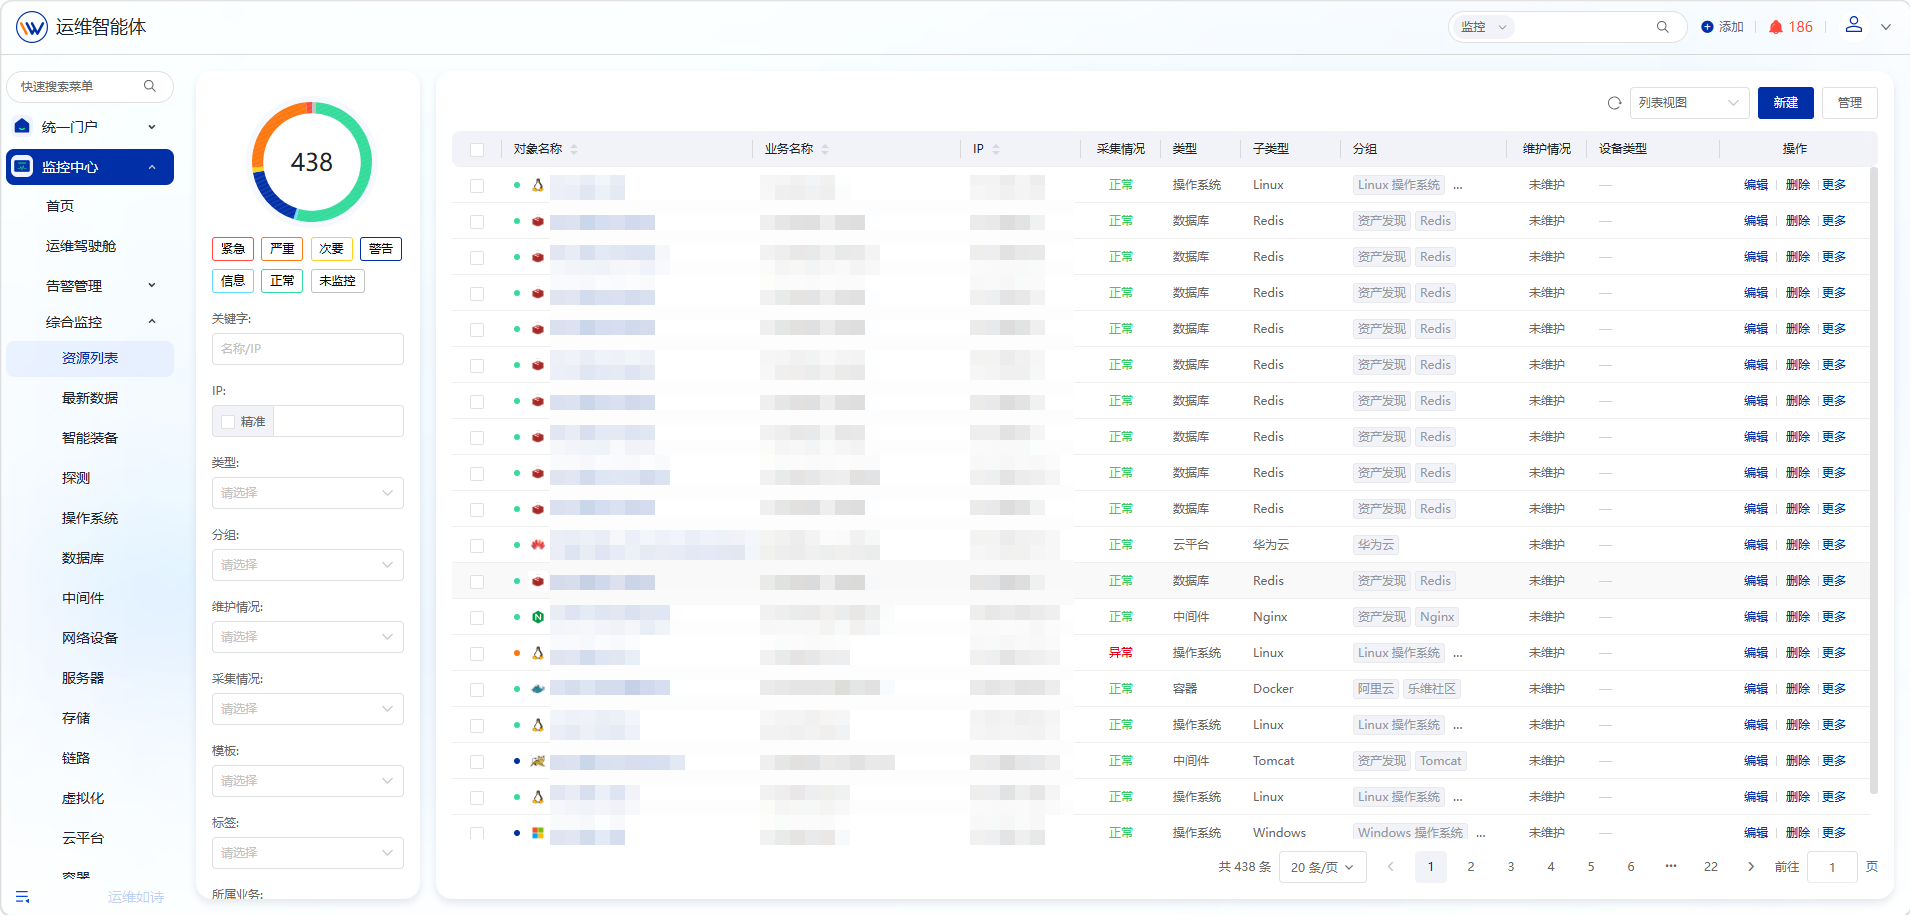
采集设备CPU、内存、磁盘、端口流量、链路状态、服务进程、数据库连接数等关键指标,实现从底层硬件到上层应用的数据直观展示与趋势分析。
值得注意的细节是采集的对象:交换机链路质量、存储控制器状态、Nginx服务进程——这些恰恰是最容易被忽略的”中间层”指标。链路质量差、存储控制器异常、进程悄然退出,这类问题往往不触发设备级告警,却是业务卡顿的常见元凶。
把它们纳入实时采集并留存历史数据,运维才第一次拥有了”事前看见隐患”的能力,同时也为后续的趋势分析和容量决策积累了数据资产。
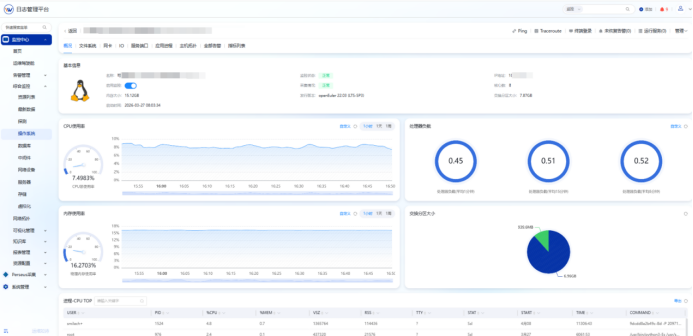
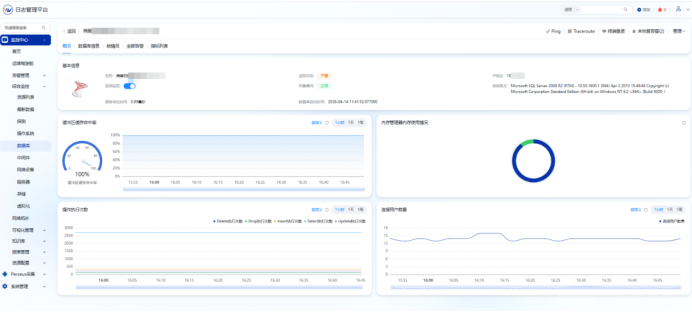
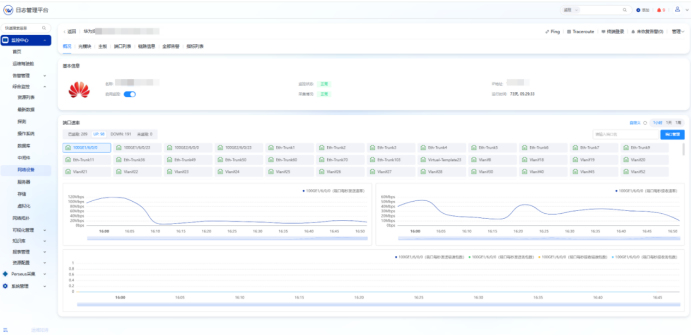
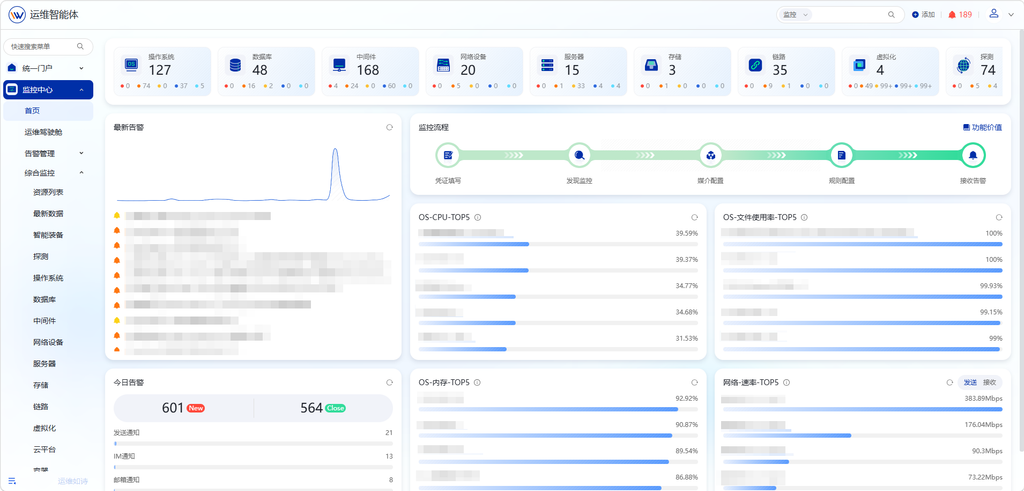
通过监控平台首页即可直观查看所有设备的核心运行指标,无需逐台登录设备查询,快速掌握整体IT资源运行状态。
这项能力的价值在于改变了运维的日常工作姿势。过去巡检是”人找问题”——逐台登录、逐项翻看;现在是”问题找人”——打开首页,全局运行状态尽收眼底,异常指标自然凸显,本质上是把前两项工作采集来的数据转化为一线运维每天的效率。
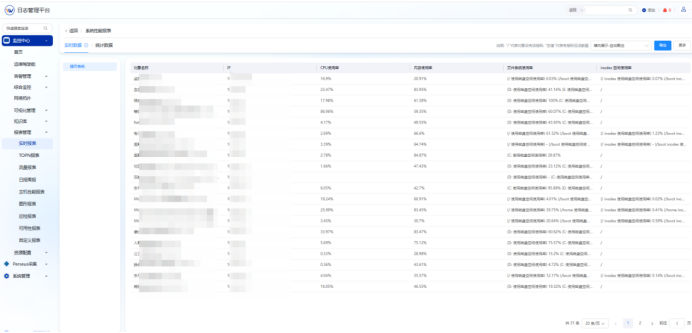
替代传统纸质/Excel记录,针对操作系统、数据库等核心系统自动生成性能指标报表,统一统计口径与格式,实现报表自动留存、多维度分析与集中管理。
乐维监控内置的报表体系覆盖实时报表、可用性报表、TOPN报表、巡检报表、流量报表、日报周报、主机性能报表等多种类型,支持自定义时间查询、报表导出与分享。
对本客户而言,关键价值有三层:一是把人工统计工作自动化,释放运维人力;二是统一口径与格式,跨部门协作有了共同语言;三是周期性报表自动留存,为扩容、迭代等运维决策提供了可回溯的量化依据。
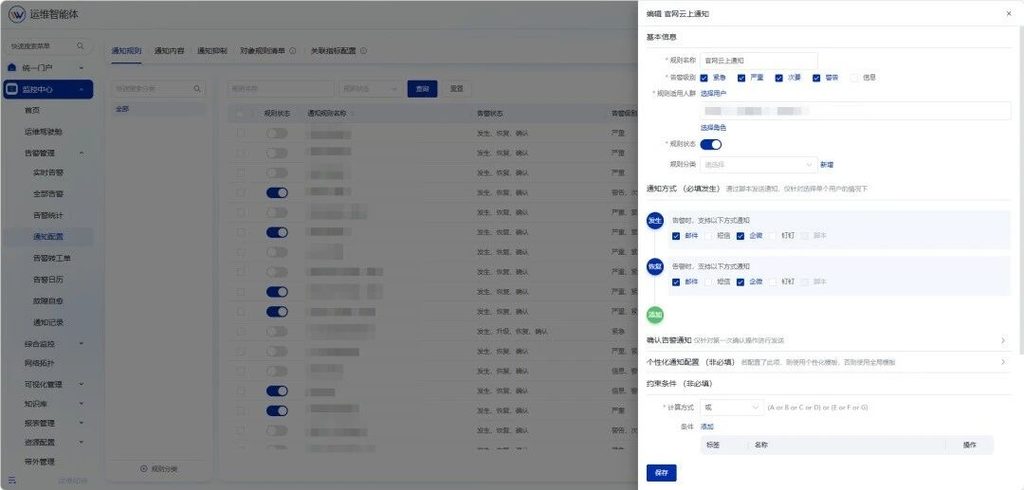
对接企业微信机器人Webhook,故障触发后自动将告警信息(含告警类型、告警标题、告警主机、主机 IP、告警时间等)推送至企微群,确保运维人员第一时间知晓并处置。
故障不再依赖”用户打电话报障”才被发现。乐维监控的告警体系支持短信、邮箱、微信、钉钉、群机器人等多种通知媒介,并配套告警响应机制与故障升级机制,避免告警发出去没人管。
选择企业微信机器人作为触达通道也很务实——该医院信息化团队普遍已在使用企微协同办公,把告警嵌入现有工作流,几乎零学习成本。一条告警消息携带主机、IP、时间、类型等要素直接进群,一线人员看到即可开始处置。
对一线运维人员:日常工作从”逐台登录巡检”变为“打开首页看全局”,从”接电话才知道出事”变为“企微群先收到告警”。同样一支团队,响应速度和覆盖面都发生了质变。
对信息科负责人/管理层:性能报表自动生成、口径统一,向上汇报和跨部门协作不再依赖手工整理的数据;设备负载、资源利用率有了历史数据,扩容和设备迭代决策从”拍脑袋”变成”看报表”。
对医院业务侧:核心业务系统获得了一层持续在线的”监测网”——硬件隐患、性能瓶颈、进程异常这些此前不可见的风险,现在能够被提前发现和快速定位,业务连续性的保障能力实质增强。
还有一个容易被忽视的角度:
架构红利,项目没有改造任何业务系统,只是在资源层之上加了一个统一监控平面——投入集中、侵入性低、见效直接。对于预算和人力都有限的医院信息科,这是典型的“小投入、高杠杆”的运维升级路径。
回看整个案例,它给出的其实是一个面向中小型IT团队的标准化解题模板
第一步,先统一入口——把所有异构资源接入一个监控平台,解决”看不见”的问题;
第二步,再采集核心指标——尤其是链路、存储控制器、服务进程这类容易被忽略的中间层,解决”看不细”的问题;
第三步,让数据流动起来——首页大屏面向日常运维,自动报表面向管理与决策,企微告警面向应急响应,分别服务三类场景。
从乐维监控的产品全景看,统一监控只是”感知层”的第一步,本案例聚焦在监控感知层的扎实落地,进阶能力可作为后续演进的候选方向——但对大多数正被”多品牌混搭、人肉巡检”困扰的医院和企业来说,把统一监控这一步走扎实,往往就是运维体系升级中性价比最高的起点。
乐维社区已经开放乐维运维智能体免费版,欢迎下载使用!


全面覆盖从IT基础架构到业务系统的可用性、性能等各项关键指标,实现全方位监控。提升运维效率,降低运维成本,保障业务连续性,推动信息化建设的科学发展。
View details

基于客户企业原有的运维体系、运维痛点与具体需求,乐维为其量身打造了一套一站式智能运维监控解决方案,搭建统一监控平台整体框架,引入智能化告警管理系统...
View details
HelloPlease log in